DBC 信号字节序:Intel 与 Motorola、起始位与换算
一条 SG_ 行如何把 CAN 载荷里的位映射为工程量数值。
更新于 2026-11-05
DBC 是 Vector 提出的纯文本数据库格式,用来描述 CAN 网络。它并不承载报文本身,而是说明如何解释报文。报文用 BO_ 声明,后跟标识符、名称、DLC 和发送节点;信号挂在报文下,用 SG_ 行描述。CM_ 添加注释,BA_ 挂属性(例如周期时间 GenMsgCycleTime),VAL_ 定义枚举值表,BO_TX_BU_ 列出附加发送节点。真实项目里的文件常以 Windows-1252 或 GBK 编码保存,只按 UTF-8 读取的解析器会悄悄弄坏信号名和注释,因此宽容的编码回退是可靠读取 DBC 的一部分。
一条 SG_ 行几乎包含提取数值所需的全部信息:信号名、起始位、位长度、字节序标记、符号标记、factor 与 offset、最小值与最大值、单位以及接收节点列表。标记只有两种,@1 表示 Intel(小端),@0 表示 Motorola(大端);长度后面跟一个减号表示原始整数有符号,换算前必须先做符号扩展。圆括号里是 factor 与 offset,方括号里是显示范围。其余都是元数据:方便人阅读,但不会改变线上传输的位。
SG_ 行逐项拆解
BO_ 256 EngineData: 8 ECU
 SG_ EngSpeed : 3|16@1+ (0.25,0) [0|16383] "rpm" Dashboard
把示例读成:信号 EngSpeed 从第 3 位开始,长度 16 位,Intel 字节序,无符号,用 factor 0.25、offset 0 换算成 rpm。物理值永远等于「原始值 × factor + offset」,而且是在原始整数提取(必要时符号扩展)之后才应用。因为起始位指的是载荷内部的某个位置,它的含义取决于字节序:@1 从字节 0 的低位向高位、跨字节继续递增;@0 则从起始位置的最高位开始,向下延伸并跨到下一个字节。所以把标记写反会得到完全不同的数值,而不是简单的字节交换。
为什么字节序决定一切
对比同一个 16 位信号在 Intel 与 Motorola 布局下占用的位
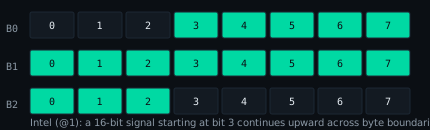
以从第 3 位开始的 16 位信号为例。Intel 布局下,前 5 位落在字节 0 的高半部分,接着 8 位填满字节 1,最后 3 位落在字节 2 的低半部分。Motorola 布局下,信号先占字节 0 的第 3 位到第 0 位,然后跳到字节 1 的第 7 位一路向下到第 0 位,再取字节 2 的第 7 位到第 4 位。两种描述都得到 16 位,但指向的是不同的物理格子。这是手工移植数据库时最常见的错误来源,也是为什么查看器最好同时展示原始整数与换算后的物理值——一写错就能立刻看出来。
DBC 常见关键字
- BO_ —— 报文(标识符、名称、DLC、发送节点)
- SG_ —— 信号(起始位、长度、字节序、符号、换算、单位)
- CM_ —— 挂在报文、信号或节点上的注释
- BA_ / BA_DEF_ —— 属性值及其定义
- VAL_ —— 符号值表,例如 0 关闭、1 打开
- BO_TX_BU_ —— 报文的附加发送节点
真实数据库往往很脏:重复的标识符、缺失的 BA_DEF_ 定义、非 ASCII 注释、声明长度超过 DLC 的信号,以及混用编码的行。好用的查看器会把这些报告成诊断信息,而不是拒绝打开整个文件,因为工程师通常需要先用上有效的那 95%。把解析结果导出成 CSV 或 XLSX 后,每条信号占一行,列出报文 ID、名称、起始位、长度、字节序、factor、offset、单位、注释和值表——这是一份可以评审、可以和下一版数据库做 diff 的产物。
在查看器里试一试
打开示例文件,或拖入自己的 DBC/A2L 文件。解析完全在本浏览器进行,不会上传任何内容。
打开查看器常见问题
SG_ 行里的 @1 和 @0 是什么?
@1 是 Intel 小端,@0 是 Motorola 大端;两者的差别在于跨字节时位如何延续。
factor 和 offset 用在哪一步?
先提取原始整数,再计算 物理值 = 原始值 × factor + offset;单位、最小值、最大值只是显示用元数据。